Anthropic снова на троне: Claude обошёл GPT-6 и Gemini — но есть нюанс
За один сентябрь Anthropic выпустила Fable 5.1 и Opus 5.5 — и забрала первые места в главных рейтингах ИИ. Разбираемся, где Claude действительно разнёс конкурентов, где OpenAI огрызается и сколько за всё это платить.
Сентябрь 2026-го в мире ИИ можно смело называть «месяцем Anthropic». Сначала, 1 сентября, компания выпустила Claude Fable 5.1 — и прямо назвала её «самой продвинутой моделью в мире для программирования и работы со знаниями». А 22 сентября добавила Claude Opus 5.5 — модель попроще и подешевле, которая, по словам компании, на большинстве задач почти не уступает флагману. OpenAI и Google, конечно, не сидели сложа руки. Но таблицы рейтингов в этом месяце окрасились в фирменный оранжевый Claude.
Цифры, от которых у конкурентов дёргается глаз
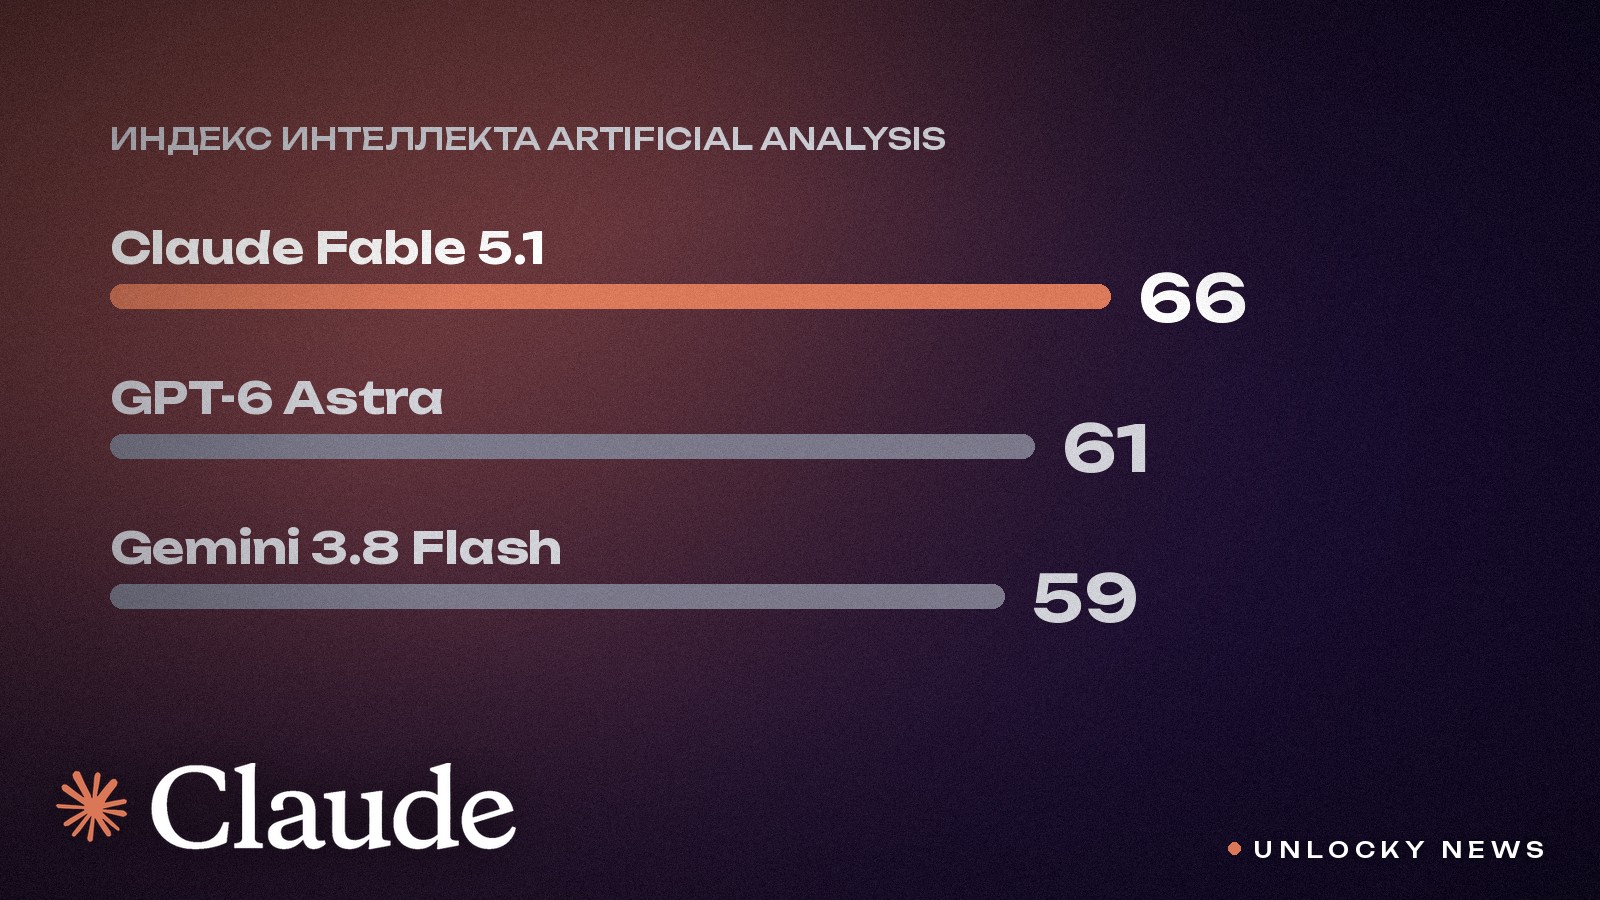
Artificial Analysis — независимые ребята, которые сами прогоняют модели через свои тесты, а не верят пресс-релизам на слово. В их общем индексе интеллекта Claude Fable 5.1 набирает 66 баллов, флагман OpenAI GPT-6 Astra — 61, а Gemini 3.8 Flash от Google — 59.
- Индекс программирования с агентами: Fable 5.1 — около 70,4, GPT-6 Astra — 67,0, Gemini 3.8 Flash — 61,1.
- Научные задачи в терминале (Terminal-Bench-Science по данным Anthropic): Fable 5.1 — 52,6%, GPT-5.6 Sol — 22,4%. Тут уже не «обошёл», а обогнал больше чем вдвое.
- Автоматизация задач (AutomationBench от Zapier): Opus 5.5 — 40,0%, свежий GPT-6 Sol — 33,2%.
Opus 5.5: флагман на распродаже
Самый хитрый ход месяца — Opus 5.5. На момент выхода, 22 сентября, он выигрывал у GPT-6 Sol во всех опубликованных тестах на программирование и работу агентов. При этом Anthropic обещает, что на типичных задачах он обходится на 40% дешевле прошлой Opus 5 и отвечает заметно быстрее.
А вот и пикантная деталь: во всех своих графиках OpenAI сравнивала новый Sol не с Opus 5.5, а с прошлой Opus 5. Объяснение простое — модели вышли с разницей примерно в полтора часа, и свежих цифр просто не было. Но осадочек, как говорится, остался: соревноваться с прошлогодним чемпионом всегда приятнее.
Где OpenAI огрызается
Чтобы не превращать новость в фан-клуб: OpenAI тоже есть чем крыть. В сложной математике модели OpenAI держат первенство — на наборе задач FrontierMath GPT-5.6 Sol набирал 89% против 87% у прошлой Fable 5. На отдельных тестах в терминале GPT-6 Sol на максимальных настройках тоже вырывается вперёд. А ещё Sol стоит ровно вдвое дешевле Opus 5.5 за токен: $2 и $10 за миллион токенов против $4 и $20.
Вывод специалистов по сравнению моделей скучный, но честный: разница между Opus 5.5 и Sol настолько небольшая, что для большинства задач выбирать стоит по цене и по тому, что вам удобнее, а не по таблицам.
А что за Mythos?
Вместе с Fable 5.1 Anthropic показала Claude Mythos 5.1. Это, по сути, та же модель, но с другим уровнем ограничений безопасности, и доступна она только участникам программ доверенного доступа. Обычным пользователям достаётся Fable 5.1 — и, судя по рейтингам, жаловаться там не на что.
Что это значит для вас
Если вы пишете код, разбираете длинные документы или поручаете ИИ многошаговые задачи — сейчас Claude, пожалуй, лучший выбор, и подписка Claude Pro открывает доступ к свежим моделям. Если важнее универсальность, картинки и голос — ChatGPT по-прежнему очень силён. А лучшая новость в том, что гонка не останавливается: каждая «победа» живёт пару недель, и в выигрыше в итоге оказываемся мы с вами.